配音、字幕、画面、背景音乐全部自动生成。竖屏横屏都能导出,附带 SRT 字幕和封面图。 出片后哪个画面不满意,可以单独换掉那一个。
开始生成,前 3 条免费下面每一条视频都是这个工具真实生成的,没有剪辑、没有挑选,输入内容原样列在卡片里。
AI 自己写分镜文案、挑关键词、配画面。适合日更账号快速起量。
自动抓取正文并改写成口播稿。做资讯、科普、书摘类账号很省事。
提炼要点成口播稿,文档里的数字会自动画成图表画面,不是配张无关的图。
AI 一个字都不改,只负责配画面、配音、打字幕。 你的语气、你的梗、你的专业措辞全部原样保留。
常见用法:
稿子长也没关系 —— 会自动断句、一句一个画面, 做三五分钟的中长视频同样能用,不是只能做 30 秒。
上传一段人声录音,自动识别成字幕, 并按每句话的实际时长去配对应的画面 —— 你说到哪,画面就跟到哪。 原声完整保留,不会被 AI 配音顶掉。
常见用法:
想露声不露脸的人最常用这一个: 不用出镜、不用剪辑,录完直接出片,字幕还自动对齐。
传一首歌,就是一支 MV。上传单曲的 MP3 或 WAV,会识别出歌词并打成字幕, 再按每句歌词的意思配画面。前奏和间奏没有歌词的部分会自动分段换画面, 不会一个镜头僵在那儿循环。原曲完整保留。
很多工具只是把按钮翻译一遍。这里是界面、文案语种、配音音色三者一起对齐 —— 你给日文选题,出来就是日文稿子配日文音色,字幕也用日文字形渲染。
| 你输入的语言 | 文案 | 配音 | 字幕字形 |
|---|---|---|---|
| 中文 | 中文 | 中文音色(8 个) | Noto Sans CJK SC |
| English | English | 英/美/澳音色(12 个) | 拉丁字形 |
| 日本語 | 日本語 | 日语音色(2 个) | Noto Sans CJK JP |
选的音色念不了稿子的语种时会自动换成对应语言的音色 —— 不会出现「英文声音念日文」这种念不出来的情况。
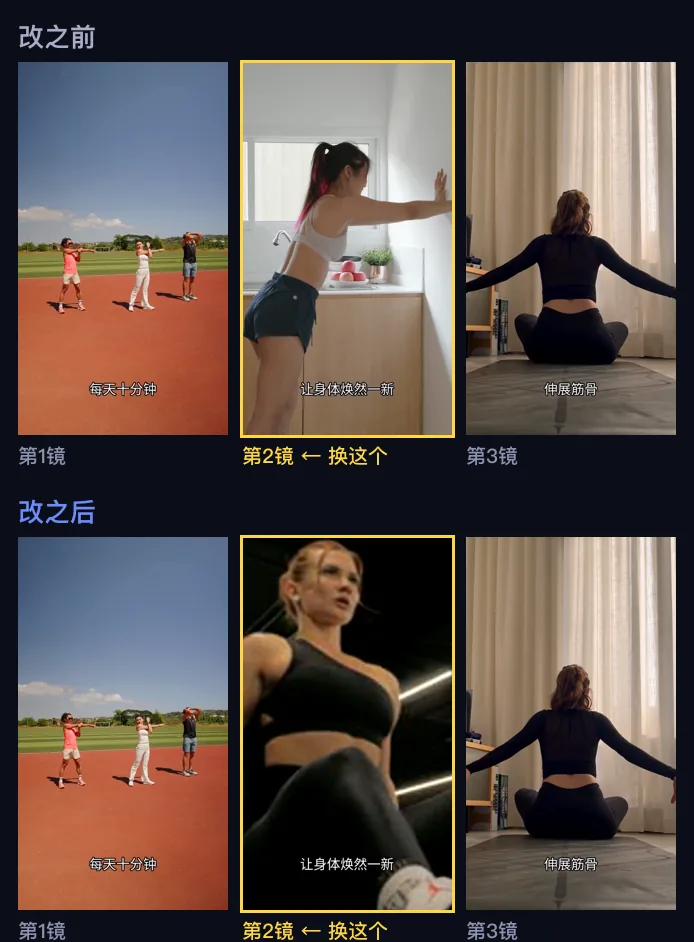
从素材库挑一条替换指定分镜,其余画面原样保留,不会整条重新洗牌。 下面是同一条视频换素材前后的真实对比。
点图可看大图
逐像素比对:第 1 镜差异 0.0、第 3 镜 2.4(视频编码噪声), 只有被指定的第 2 镜换掉了。
会列出每个分镜当前用的画面缩略图。
从分类素材库里挑一条替换。
只有你换的那一镜变,配音、字幕、其他画面全部保持原样。
22 个音色,中英日三语,可试听后再选。
字号、颜色、位置可调,也可以关掉。
按每句话的意思检索正版图库,不是套模板。
按内容情绪自动选曲,也可以手动指定风格。
单独下载,发布到各平台时可单独上传。
自动抽帧,直接当视频缩略图用。
画幅支持竖屏 9:16、横屏 16:9,可以一次同时导出两个版本。
画面来自正版授权图库的真实素材, 不是逐帧 AI 生成的。所以:
✅ 适合:口播讲解、清单科普、资讯复述、不露脸账号、文档转视频、 讲稿与课件转视频、三五分钟的中长内容
❌ 不适合:需要特定虚构场景、角色一致性、电影级运镜的内容
短视频通常一分钟以内。长稿会久一些 —— 时长主要取决于分镜数量。
界面有简体中文、繁体中文、日文、英文四种。文案语种跟着你的内容走, 配音音色和字幕字形也会一起对齐。
不会。选「我的文案」时一个字都不动,AI 只负责配画面、配音和字幕。
可以。上传录音后原声完整保留,不会被 AI 配音顶掉,字幕按每句话的 实际时长自动对齐。
可以。上传单曲的 MP3 或 WAV,会识别歌词打成字幕,再按歌词配画面。 前奏和间奏没有歌词的部分会自动分段换画面。
不是。用的是正版授权图库的真实素材,按每句话的意思检索匹配。
可以只替换那一个分镜,其余画面、配音和字幕原样保留,不用整条重做。
MP4,竖屏 9:16 和横屏 16:9 都能导出,还附带 SRT 字幕文件和封面图, 抖音、TikTok、YouTube Shorts、Reels 都能直接发。
出片后不满意的片段可以单独替换,不用整条重做。
 一键图文成片